いま、MCPはAIエージェントと外部サービスをつなぐ共通の接続方式として使われています。その一方で、「MCPよりCLIで十分ではないか」と、MCPを使う意味が問い直された時期もありました。
CLIが支持されたのには理由があります。エージェントは必要なときにヘルプを読み、コマンドを組み合わせ、出力を加工できます。初期のMCP利用では、ツール定義や検索結果をまとめてモデルへ渡す実装が、コンテキストを圧迫する問題を生んでいました。初期化や、セッションを使う場合の状態管理にも負担がありました。すでに使えるCLIがある環境では、それをそのまま使わせるほうが手軽な場面もあったのです。
MCPの再評価は、こうした不満への対応とともに進んできました。2026年7月28日版では、初期化のやり取りやプロトコル上のセッションが撤去され、リモートのMCPサーバーを分散して運用しやすくなりました。AIアプリ側でも、必要なツール定義だけを読み込む、コードで結果を加工してからモデルへ返す、といった工夫ができます。
この見方の変化を表しているのが、次の投稿です。
投稿者は「予想していなかった」としながら、多くの統合でCLIよりMCPのほうがよいと考えるようになった、と述べています。理由として挙げているのは、モデルのツール呼び出し能力、ツール定義の遅延読み込み、MCPのステートレス化です。データの組み合わせや絞り込みには、queryのような引数を用意すればよい、とも書いています。
MCPの復権を理解するには、なぜCLIが支持されたのかと、その理由にMCP側がどう対応したのかを、続けて見る必要があります。
ここでいう「復権」は、CLIを選ぶ理由だった課題への対応が進み、MCPの利点を改めて評価する根拠が増えたことを指します。
この記事では、MCPへの期待、CLIを見直す議論、MCPの再評価へ至る変化をたどります。モデルの能力、AIアプリ側の実装、2026年7月28日版の仕様変更を分けながら、クラウドエージェントでMCPを使う意義まで整理します。
記事を通して使う例は、AIアプリから、顧客サポートの問い合わせ管理システムを操作する場面です。このシステムには、「商品が届かない」「配送先を変更したい」といった顧客の質問や相談が、担当者や対応状況とともに記録されています。AIに未対応の記録を探してもらう、対応済みに変更してもらう、CSVへ書き出してもらう、といった流れで説明します。以降の「問い合わせ」は、このシステムに保存された一件ずつの記録を指します。
1 MCPは、AIが外部サービスを使うための共通ルール
まず、AIに「まだ対応していない重要な問い合わせを一覧から探して、担当者ごとにまとめて」と頼むところから考えてみましょう。
モデルは依頼の意味を理解できても、それだけで社内の問い合わせシステムを検索できるわけではありません。検索するプログラムを呼び、結果を受け取る必要があります。
ここで、AIモデルと、それを使うアプリを分けて考えます。ChatGPTやClaude Desktopのようなアプリは、利用者の依頼をモデルへ渡し、モデルが選んだツールを呼び出し、その結果をモデルへ返す役割を担います。この記事では、こうしたアプリを「AIアプリ」と呼びます。
そのアプリと外部サービスのつなぎ方を共通化するのが、MCP(Model Context Protocol)です。サービス側が「どんな操作を使えるか」「何を引数に渡すか」を公開し、アプリ側がMCPの決まった手順で取得して呼び出します。MCP公式仕様の概要
たとえば、問い合わせサービスがsearch_ticketsというツールを公開します。引数には状態、優先度、取得件数を指定できます。定義を読んだモデルが検索条件を選び、AIアプリがツールを呼びます。
MCPの用語では、このアプリ全体をホスト、アプリの中でMCP通信を担当する部分をクライアント、外部サービスの操作をMCPで公開する側をサーバーと呼びます。モデルが操作と引数を選び、アプリが実際の呼び出しを担当する流れを、次の図に示します。
この構成では、モデルが操作と引数を選び、HTTP通信や認証情報の扱いはAIアプリが担います。MCPサーバーの内側では、既存のAPIやデータベースを使ってもかまいません。ホスト・クライアント・サーバーの公式仕様
既存APIを置き換える必要もありません。問い合わせサービス固有のAPIの手前に、AIアプリが共通の方法で使える窓口を置く仕組みです。
MCPには、操作を提供するToolsのほか、文書などを提供するResources、定型のやり取りを提供するPromptsもあります。CLIとの比較が中心なので、ここでは主にToolsを扱います。
2 なぜMCPへの批判が生まれ、CLIが再評価されたのか
MCPへの期待は分かりやすいものでした。一度サービスをMCPに対応させれば、互換性のあるAIアプリから使えます。アプリごとに専用の接続処理を書く負担が減ります。
ただ、ツールが増えると別の問題が目立つようになりました。
問い合わせを検索したいだけなのに、作成・更新・削除・添付・利用者管理まで、大量のツール定義をモデルへ渡してしまいます。検索結果にも不要な項目が大量に返り、作業と無関係な情報でコンテキストが埋まっていきます。
一方、コーディングエージェントは既存のCLIやコード実行環境で同じ仕事を進められました。詳しい使い方は必要なときに読み、結果はプログラムで加工できます。「同じ仕事ができるなら、MCPという接続層を足す必要があるのか」という疑問が出てきました。
Mario Zechnerは2025年11月の記事で、ブラウザー操作を例にこの問題を指摘しました。多数のMCPツール定義と中間結果がコンテキストを圧迫します。少数のCLIとコードで処理するほうがよい、という提案です。
mariozechner.atWhat if you don't need MCP at all?Got Bash and some code interpreter? Skip MCP.mariozechner.at ↗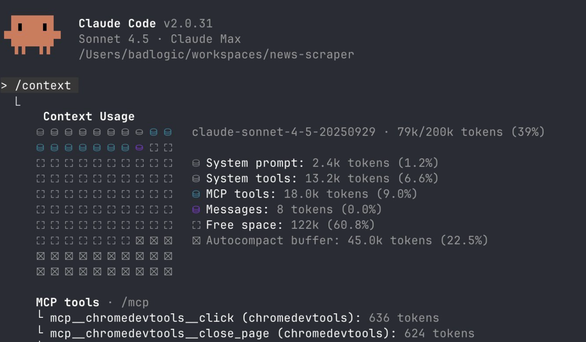
Peter Steinbergerも、Lex Fridmanとの対談で、CLIのヘルプを必要なときに読む方法や、出力をjqで絞る利点を話しています。ヘルプの話は2時間39分24秒、jqによる絞り込みの話は2時間41分53秒から読めます。
CLIが支持されたのは、古い技術への郷愁からではありません。説明を読む量、処理の自由度、既存資産の再利用が、エージェントの仕事に実用的だったからです。
これらは、市場全体でMCPの利用が減ったことを示すものではありません。ここで取り上げているのは、MCPを無条件に選ぶ考えへの批判と、CLIを見直す議論です。
3 CLIなら必要なものだけ読み、加工してからAIへ返せる
CLI(Command Line Interface)は、コマンドと引数でプログラムを操作する方法です。強みは、エンジニアが使ってきた道具の組み合わせを、エージェントもそのまま使えることにあります。
必要な説明だけを、その場で読める
問い合わせ管理のCLIがあることを知っていれば、詳しい使い方は--helpで確認できます。すべてのサブコマンドの説明を、会話の最初からモデルに渡しておく必要はありません。
正確に使うには説明が必要です。「CLIならトークンを使わない」わけではありません。説明を必要な時点まで後回しにしやすいのが利点です。
モデルへ返す前に、結果を絞り込める
この問い合わせ管理システムにCLIが用意されているとすると、次のように使えます。コマンドは説明用の架空のもので、JSONの配列を返すものとします。
support tickets list --status open --json \
| jq '[.[] | select(.priority == "high") | {id, title, assignee}]'CLIが未対応の問い合わせを取り、jqが優先度の高いものを選び、ID・件名・担当者だけを残します。パイプ全体を実行して最後の出力だけモデルへ返すなら、途中の大きなJSONはコンテキストに入りません。
大量のデータから対象を選ぶ処理を、モデルからプログラムへ移しています。モデルが読まなくてよい情報を、プログラムで先に取り除けるのが良いところです。
複数の処理をまとめ、人間も再現できる
担当者ごとの件数を数えたり、別サービスのデータと突き合わせたりする処理も、スクリプトにできます。途中でモデルに戻って判断を求めず、最後の結果だけ渡せます。
問題が起きれば、人間も同じコマンドを実行して調べられます。既存のCLIやスクリプトを再利用できることも含め、整った開発環境では強い選択肢になります。
4 MCPの不満は、仕様の問題と実装の問題に分かれる
CLIの利点を踏まえると、従来のMCPで不満になった点も整理しやすくなります。
まず、全ツール定義を一括で提示する実装では、使わない機能の説明までコンテキストに入ります。次に、ツールの結果を毎回そのままモデルへ返す実装では、中間データも大量に入ります。サービス側が検索条件を公開していなければ、結果を小さくするのも難しいです。
さらに、旧仕様には初期化のやり取りがあり、HTTPでセッションを使う構成もありました。利用者のPCで単純に呼ぶ場合には意識しにくいですが、多数の利用者を複数台のサーバーで処理する側には、通信状態を管理する負担があります。旧版の初期化手順、旧版のHTTP通信仕様
これらは同じ種類の問題ではありません。次の表は「何が不満だったか」だけでなく、どこを直せば改善するかを整理したものです。
| 問題になったこと | 主な原因 | 改善する場所 |
|---|---|---|
| 使わない操作の説明までAIが読む | 全ツール定義を最初に提示する | AIアプリ側のツール選択と遅延読み込み |
| 大量の検索結果や中間データが入る | 結果をそのままモデルへ戻す | ツールの検索引数、実行環境での加工 |
| サーバーを増やすと通信管理が複雑になる | 初期化時の情報やセッションへの依存 | プロトコルとサーバーの設計 |
最初の二行は、MCPで必ず起きる問題ではありません。ホストやツールの設計による部分が大きいです。最後の行の問題は、通信規約自体を見直すことで、状態を管理する負担を減らせます。
7月28日版に更新しても、問い合わせ検索で返す件数や項目は、それだけでは変わりません。モデルに渡すデータを減らすには、検索条件で件数を絞ったり、取得したデータから必要な項目だけを取り出したりする工夫が必要です。一方、今回の仕様変更では、MCPの初期化やプロトコル上のセッション管理が不要になり、複数のサーバーへ処理を振り分けやすくなります。
5 7月28日版で、MCPの通信はどう変わったか
2026年7月28日版は、直前の2025年11月25日版から、通信の基本構造を変えました。機能を足すだけでなく、初期化やセッションを取り除き、要求と応答を中心に組み直した版です。2026年7月28日版の公式リリース
初期化とプロトコルのセッションを撤去した
旧仕様では、まずinitializeでプロトコルの版や対応機能を取り決め、初期化完了の通知を送ってから操作していました。HTTPでは、サーバーはMcp-Session-Idを任意で発行できました。発行は任意だったので、「以前のMCPは必ずセッションストアを必要とした」とまでは言えません。
新版は、initializeとnotifications/initializedのやり取りを撤去しました。代わりに、各要求がプロトコルの版とクライアントの対応機能を_metaに含めます。HTTPのMcp-Session-Idも撤去されました。バージョンと互換性の公式仕様
通信の順番で見ると、次のようになります。ツール定義の取得や認証は省略し、初期化の違いだけを示しています。
旧版:初期化してから操作する
新版:要求ごとに必要な情報を添える
新版の図では、次の要求を別のサーバーが受け取っても、前のサーバーから初期化情報を引き継ぐ必要がありません。サーバーは、過去の要求や同じ接続でのやり取りから、バージョンや対応機能を推測してはいけません。ステートレス化の公式仕様
要求に付けるメタデータは、たとえば次の形になります。これはparams._metaの部分だけを抜き出した例です。
{
  "io.modelcontextprotocol/protocolVersion": "2026-07-28",
  "io.modelcontextprotocol/clientCapabilities": {},
  "io.modelcontextprotocol/clientInfo": {
    "name": "SupportAgent",
    "version": "1.0.0"
  }
}バージョンとクライアント能力は必須で、clientInfoは推奨される自己申告情報です。ログイン済みの利用者を証明する情報ではありません。HTTPでは、バージョンを表すMCP-Protocol-Versionヘッダーも付けます。要求に付けるメタデータの公式仕様
事前にサーバーの対応版や機能を確認したい場合は、新設のserver/discoverを使います。サーバーは実装しなければなりませんが、クライアントが操作の前に必ず呼ぶ必要はありません。新しい名前の初期化ハンドシェイクに置き換わったわけではありません。サーバーの対応機能を確認する公式仕様
運用上は、MCPを普通のHTTPサービスに近い感覚で分散させやすくなります。 セッションの都合で要求を同じインスタンスへ戻す必要を減らせます。
業務上の状態は残ります。買い物かごを作ったなら、後続の呼び出しにbasket_idを渡して参照します。かごの内容はDBや既存の業務サービスなどで管理しますが、保存方法をMCPが指定するわけではありません。ステートレス化は「何も保存しない」ことではありません。過去の接続や暗黙のセッション情報に依存せず、要求に必要な情報を明示する、という意味です。業務上の状態を扱うツールの公式仕様
利用者への確認は、いったん応答を返してから再要求する
カスタマーサポートの担当者が、顧客から届いた20件の質問に返信を終えたとします。あとは、問い合わせ管理システムに残っている20件の記録を、「対応中」から「対応済み」へまとめて変更したい場面です。
担当者は対象の20件を選び、AIアプリに「この20件を対応済みにして」と依頼します。AIアプリは、対象の記録のIDを指定して、MCPサーバーへ状態の変更を要求します。この例では、サーバーが実行前に担当者の確認を求めるものとします。
この確認には、AIアプリが利用者への質問を受け付ける機能(Elicitation)に対応し、その対応をMCP要求に示している必要があります。
サーバーは、この時点では記録を更新せず、「この20件を対応済みにしますか」という質問を応答に含めて返します。AIアプリがその質問を担当者に表示し、「はい」という回答を受け取ったら、同じ20件の変更を、回答とともに改めて要求します。サーバーが更新するのは、この再要求を受け取って、回答や権限を確認した後です。
このように、追加入力が必要ならいったん応答を返し、入力を添えた新しい要求で処理を進める方式を、Multi Round-Trip Requests(MRTR)と呼びます。追加入力と再要求(MRTR)の公式仕様
次の図では、担当者の依頼から更新の完了までを示します。
ポイントは、担当者が回答する前に、1回目の要求への応答を返せることです。サーバーは、担当者が考えている間、その要求の通信をつないだまま待つ必要がありません。再要求に必要な情報を添えれば、複数台で運用する構成では別のサーバーが続きを処理することもできます。
仕様上は、「確認が必要」という応答をresultType: "input_required"で表し、inputRequestsに質問を入れます。AIアプリは、担当者の回答をinputResponsesに入れ、新しいリクエストIDで再要求します。更新が完了した結果はresultType: "complete"で返します。
サーバーが再開用の情報としてrequestStateを返した場合は、AIアプリがその値を変更せずに再要求へ添えます。業務判断に使う情報なら、サーバー側で改ざんを検出できる設計が必要です。
CLIにも確認プロンプトはあります。MCPでは、「追加入力が必要」という共通形式をAIアプリが受け取り、自分の画面に合った方法で担当者へ質問を表示できます。サービスごとに端末の出力を読み解く実装を減らせるのが利点です。実行前の回答や権限の検証は、サーバー側で引き続き必要になります。
ツール一覧などのキャッシュに共通ルールができた
サービスが提供するツールの定義は、毎秒変わるものではありません。変わっていない定義を何度も取得するのは無駄ですが、いつまで再利用してよいかを勝手に決めると、古い定義で呼び出す問題が起きます。
新版では、tools/list、server/discover、resources/readなど、対象となる完了結果にttlMsとcacheScopeが必須になりました。キャッシュの公式仕様
ttlMs: 300000なら、5分間は新鮮な結果として扱えるという目安になります。cacheScope: "private"なら、異なる認可コンテキストへ共有してはいけません。全利用者に共通する公開情報ならpublicを選べます。
たとえば、AIアプリが保持している問い合わせツールの一覧がまだ新しければ、再取得せずに使えます。関連する変更通知が届けば、有効期限内でも無効化します。これは通信結果のキャッシュであり、モデル提供者のプロンプトキャッシュとは別の仕組みです。
この変更は、後述する遅延読み込みを支えます。定義をホスト側へ保存しておき、必要なときにモデルへ提示する構成で、取得の負担を抑えられます。ただし、任意のtools/call結果まで自動的にキャッシュしてよい規約ではありません。
HTTP基盤から、どの操作か識別しやすくした
Streamable HTTPを使う構成では、MCPのツール呼び出しは同じHTTPエンドポイントへ送られます。本文を見なければ、問い合わせの参照と削除を区別しにくくなります。
新版では、メソッドを表すMcp-Methodヘッダーを要求に付け、tools/callなどでは対象名をMcp-Nameへ入れます。たとえば、Mcp-Method: tools/callとMcp-Name: search_ticketsという形です。操作名を伝えるHTTPヘッダーの公式仕様
これにより、ゲートウェイが本文を解析せずに操作を識別しやすくなります。参照と削除で呼び出し頻度の制限を変える、特定の処理を別のサーバー群へ振り分ける、といった構成を作りやすくなります。さらに、ツール定義のx-mcp-headerで、指定した引数をヘッダーへ反映する仕組みもあります。
ヘッダーは権限の証明ではありません。本文との一致を検証し、利用者の権限を確かめる必要があります。既存のHTTP運用基盤が、MCPの操作を扱いやすくなる効果が得られます。
変更通知は、必要な更新だけ受け取る
問い合わせ管理サービスに新しいツールが追加されても、AIアプリが古い一覧を持ったままでは使えません。そこで、「ツール一覧が変わったら知らせてほしい」とサーバーに登録します。これが通知の「購読」です。通知を受けたAIアプリは、tools/listで最新の一覧を取得します。
新版では、subscriptions/listenで受け取りたい通知を指定します。従来の通知待ち用のHTTP GETや、リソースごとの購読・解除の操作は、この仕組みに置き換わりました。
HTTPではSSEという方式で通知を順に受け取り、その間は通知用の通信を維持します。個々のツールを呼び出す要求とは別の通信です。変更通知の購読に関する公式仕様
長時間処理は、タスクIDで後から結果を受け取る
大量の問い合わせの記録をCSVへ書き出すなど、時間がかかる処理にはTasks拡張を使えます。サーバーは完成したファイルの代わりに、受付番号にあたる「タスクID」を先に返し、処理を続けます。
AIアプリはtasks/getで状況を確認し、完了していれば最終結果を受け取ります。途中で担当者の入力が必要になった場合は、tasks/updateで回答を渡します。MRTRが追加入力を添えて操作を再要求する仕組みなのに対し、Tasksは継続中の仕事をIDで追跡する仕組みです。
今回、従来のコア仕様にあった実験的なTasksが公式拡張へ分離・再設計されました。利用には、AIアプリとサーバーの双方が対応を明示する必要があります。長時間処理を扱うTasks拡張の公式仕様
認可は、発行元の取り違えを防ぐ
認可は、利用者に代わってAIアプリがどのデータを読み、どの操作を行ってよいかを扱う仕組みです。たとえば社内サービスでは、利用者がログインしてアクセスを許可し、AIアプリが権限を示すアクセストークンを取得します。
今回、ログインや許可の後に戻ってくる「認可応答」を、別の認可サーバーからの情報と取り違えないための確認が強化されました。
AIアプリは、検証済みのメタデータから認可サーバーの発行元を記録します。応答に発行元を表すissがあれば照合し、不一致なら拒否します。図はissが含まれる場合です。
サーバーが「issを返す」と宣言しているのに含まれていない場合も拒否します。取得したクライアントIDや秘密情報も、別の認可サーバーへ流用せず、発行元ごとに管理します。認可の公式仕様
アプリの情報を認可サーバーへ伝える「クライアント登録」も整理されました。
| 方法 | 仕組み | 今回の位置付け |
|---|---|---|
| DCR(動的クライアント登録) | 登録用APIへアプリの情報を送り、クライアントIDを発行してもらう | 非推奨。既存の接続との互換性のために残る |
| CIMD(Client ID Metadata Documents) | アプリの情報をJSONとしてHTTPSで公開し、そのURLをクライアントIDにする | クライアントと認可サーバーに対応を推奨 |
事前登録されたクライアント情報があれば、それを優先します。クライアント登録の公式仕様
構造化データは、配列のまま返せる
structuredContentは、ツールの結果をプログラムが扱いやすいJSONで返すための項目です。従来、問い合わせの一覧は、次のようにオブジェクトで包む形でした。以下はデータ部分だけの例です。
{
  "tickets": [
    { "id": "T101", "title": "商品が届かない" }
  ]
}
新版では、配列のまま返すこともできます。
[
  { "id": "T101", "title": "商品が届かない" }
]文字列、数値、真偽値、nullも扱えます。出力スキーマが定義されていれば、その型のルールに従います。入出力スキーマも、JSON Schema 2020-12の表現をより広く使えるようになりました。
構造化出力そのものは2025年6月18日版からあり、今回は表現できるデータの範囲が広がった変更です。ツールと構造化出力の公式仕様、2025年6月18日の変更一覧
移行時は、非推奨機能と接続の互換性を確認する
「非推奨」は、現在の仕様には残るものの、新しく採用するのは避け、既存の実装は移行を進める段階です。今回、次の機能が非推奨になりました。
| 機能 | これまでの役割 | 移行先 |
|---|---|---|
| Roots | 作業に関係するファイルやディレクトリを伝える | ツールの引数、リソースURI、サーバー設定 |
| Sampling | AIアプリ側のモデルに文章生成などを依頼する | モデル提供者のAPIを直接利用 |
| Logging | サーバーのログをMCP経由で送る | stdioでは標準エラー出力、運用上の可観測性にはOpenTelemetryなど |
これらの機能の非推奨化とは別に、接続確認のpingや、ログの出力レベルを設定するlogging/setLevelなどの操作は撤去されました。公式の非推奨機能一覧、2026年7月28日版の公式変更一覧
また、新版の方式だけに対応したサーバーは、旧版の初期化を前提にするクライアントを扱えません。既存のAIアプリも使い続けるなら、一つのエンドポイントで新旧両方の方式を提供することもできます。新旧バージョンの互換性に関する公式仕様
再要求では、業務上の二重実行を防ぐ
新版では、Last-Event-IDによるSSEの再開・再配信が撤去されました。通信が切れて処理を再要求するときは、新しいリクエストIDを使います。
ただし、操作が完了していても、返答だけが届かない場合があります。顧客への返信が送信済みなのに、同じ送信を再要求すると二重送信になりかねません。図は、業務用の操作IDで同じ仕事だと識別し、送信済みなら結果だけを返す設計例です。
MCPのリクエストIDは、要求と応答を対応付けるものです。業務用の操作IDはツール側で用意するもので、MCPが自動で重複を除くわけではありません。HTTP通信と再要求の公式仕様
図は送信済みの記録を確認できる場合の例です。送信後、記録を保存する前にサーバーが停止する場合まで扱うには、送信サービス側の重複防止機能なども含めた設計が必要になります。
6 この変更で、実際のAIとのやり取りはどう変わるのか
仕様変更だけ追っても、冒頭の投稿の半分しか見えません。ここまで使ってきた問い合わせ管理システムで、検索から結果をまとめるまでの流れを考えてみましょう。
検索したいときに、検索ツールだけを読む
AIアプリは、サーバーから取得したツール定義を保持しておけます。それを最初から全部モデルへ渡さず、「問い合わせを検索する」という仕事に必要な定義だけ提示します。
公式ガイドでは、この方法をProgressive Tool Discoveryとして説明しています。ホストが用意する軽量な検索手段で候補を見つけ、必要な定義を読み込みます。CLIで必要なコマンドのヘルプだけを読むのと、同じ方向の工夫です。必要なツール定義だけを読み込む実装ガイド
ここで、サーバーの能力を確認するserver/discoverと、モデルに見せるツールを選ぶ仕組みは別物です。後者はホストが実装します。ツールが少数なら、一括で渡したほうが単純で、検索の往復もいりません。
2026年8月22日の公式ロードマップでは、サーバーが小さな入口から必要な機能を段階的に公開する仕組みも、今後の優先課題に挙がりました。ホスト側ですでに実装できる遅延読み込みと、サーバー側の公開方法まで含めた標準化の計画は区別する必要があります。2026年8月の公式ロードマップ解説
取得する段階で、必要な情報へ絞る
検索ツールには、状態、優先度、取得する項目などの引数を用意します。次はAPI設計を示す概念例であり、特定SDKの実行コードではありません。
search_tickets(
  status = "open",
  priority = "high",
  fields = ["id", "title", "assignee"],
  limit = 20
)
これなら、不要な問い合わせや長い本文を、モデルへ送る前に除けます。サーバー側の検索へ条件を渡せるなら、データの転送量も抑えられます。
投稿の「queryのような引数を追加すればよい」は、この設計を指します。ただし、queryという名前の共通言語がMCPに追加されたわけではありません。固定的な条件なら、statusやpriorityを列挙型にするほうが、何を指定できるか明確になります。
自由な検索式を受け付ける場合は、構文、権限、取得上限をサーバー側で定義します。引数を追加するだけで、任意のクエリが安全・効率的になるわけではありません。
中間の加工を、モデルの外で処理する
担当者の所属部署を別のサービスから取得し、問い合わせと突き合わせたい場合はどうでしょうか。
すべての結果をモデルへ返して一件ずつ処理させる代わりに、ホストの実行環境でツールを呼び、コードで突き合わせる構成を取れます。モデルは処理のコードを作り、実行環境が検索・結合・集計します。最後に、担当者別の件数など必要な結果だけをモデルへ返します。コードでツールを組み合わせる実装ガイド
これはCLIのパイプと同じく、中間データをモデルのコンテキストへ通さずに済む方法です。Anthropicは2025年11月4日に、このようにコードからMCPツールを呼ぶ設計を紹介しています。7月28日版で初めて可能になったものではありません。
www.anthropic.comCode execution with MCP for efficient agentsLearn how code execution with the Model Context Protocol enables agents to handle more tools while using fewer tokens, reducing context overhead by up to 98.7%.www.anthropic.com ↗
実行環境の隔離や各呼び出しの認可は必要になります。それでも、データを組み合わせる自由度を求める場面で、必ずCLIを選ぶ必要はありません。
投稿に出てくる変化は、すべて同じ場所で起きたわけではない
ここまでを踏まえ、冒頭の投稿が挙げた4つの主張を整理します。次の表は性能順位ではありません。どの効果を得るために、どの部分が対応している必要があるかを示しています。
| 投稿の論点 | 変わる部分 | 実装・評価で確かめること |
|---|---|---|
| モデルがツール呼び出しを得意になった | モデルの能力 | 使用するモデルが、対象ツールを正しく選び、引数を作れるか |
| ツールを遅延読み込みできる | AIアプリの実装 | 必要な定義だけ提示する仕組みがあるか |
| MCPがステートレスになった | 7月28日のプロトコル変更 | クライアントとサーバーが新版へ対応しているか |
| queryなどで加工・絞り込みできる | ツールのAPI設計やコード実行環境 | 条件指定や集計を、モデルへ返す前に実行できるか |
この表のうち、今回の仕様が直接変えたのはステートレス化です。遅延読み込みや検索引数は、それを利用するアプリやツールが実装します。モデルの能力向上は、MCP仕様を読んでも証明できません。
したがって、新仕様へ更新するだけで、すべての呼び出しが速く安くなるとはいえません。これらを組み合わせれば、MCPが持っていた通信上の負担を減らせます。ツール定義や検索結果を必要な範囲に絞ることで、モデルが読む情報量も減らせます。
7 クラウドエージェントへの移行が、MCPを選ぶ理由を強くする
CLIとMCPの比較では、エージェントがどこで動くかも重要です。自分のPCでうまくいく構成を、そのままクラウドへ持ち込めるとは限りません。
手元のPCには、すでに使える環境がある
ローカルのエージェントは、インストール済みのCLI、設定ファイル、作業ディレクトリを利用できます。許可された認証情報もあれば、コマンドを実行するだけで仕事を始められます。
CLIの手軽さは、この準備済みの環境に支えられています。「1つコマンドを呼べばよい」の前に、誰かが環境を用意しているのです。
クラウドでは、その環境を配布・更新する必要がある
タスクごとに起動する短命なコンテナでエージェントを動かすなら、必要なCLIと依存関係をそこへ用意します。利用するサービスが増えれば、CLIのバージョンや設定の管理対象も増えます。
コンテナイメージへ事前に組み込む方法はあります。CLIが不利だから不可能、という話ではありません。ただ、そのイメージの更新や利用者ごとの権限設定も、クラウド側で運用する仕事になります。
一人の開発者が使うPCでは小さかった負担が、複数の利用者や多数の実行環境へ広がると目立つようになります。そこで、サービス固有の処理をエージェントの実行環境から分離する意味が大きくなります。
リモートMCPなら、サービスの実行環境をサーバー側へ置ける
リモートMCPでは、ツールの実装や依存関係をサーバー側で管理し、エージェントはHTTPで接続します。エージェントごとに、サービス専用の実行プログラムを配置する必要を減らせます。リモートMCPへの接続ガイド
次の図は、同じ業務サービスへアクセスする2つの構成を比べたものです。上側では各実行環境にサービス専用CLIを置きます。下側では共通のMCPクライアントから、サービス側に置いたツールを呼びます。
減らせるのは、サービス固有の実行環境を各エージェントへ配る負担です。認証や認可が不要になるわけではありません。認可が必要な接続では、MCPクライアントも接続先で有効なアクセストークンなどを使い、サーバーは利用者ごとの権限を検証します。認可の公式仕様
また、CLIでも資格情報を外部の管理基盤から受け取れるため、「CLIなら秘密情報を必ず配りっぱなしにする」という比較は正しくありません。MCPの利点は、接続・機能の発見・呼び出しを扱う共通の層を作りやすいことにあります。
ステートレス化で、サーバーの分散運用がしやすくなる
リモートMCPは7月28日より前から存在しました。今回の変更で改善されたのは、多数のエージェントから来る要求を処理する側の通信モデルです。
エージェント側は共通のクライアントを使い、サービス固有の実装をサーバー側へ寄せます。サーバー側は、その要求をどのインスタンスで処理するかを、プロトコルのセッションに縛られず決めやすくなります。ステートレス化の公式仕様
これは、クラウドでの分散運用と相性がよいです。ただし、エージェントが再起動しても会話や作業が自動で復元されるわけではありません。作業履歴や業務ハンドルの保存は、エージェント側で別途考える必要があります。
複数のクラウドエージェントから同じサービスを使う構成では、リモートMCPによる共通化と集中管理の価値が高まりやすくなります。 これは仕様から導ける設計上の評価であり、「クラウドではCLIが使えなくなる」という予測ではありません。
製品側にも、接続設定を共通化する動きがあります。GitHubは2026年10月28日、GitHubが検証したMCPサーバーを「コネクター」として提供するパブリックプレビューを発表しました。一度接続したサービスをCopilot CLI、VS Code、クラウドなどから利用できるというものです。これは7月28日版への対応状況を示す発表ではありませんが、複数の実行環境で同じ接続を使う具体例になります。Copilotコネクターの公式発表
8 MCPの復権を支えたものと、CLIとの使い分け
ここまでの話を、今度はこの問い合わせ管理システムの提供側から考えてみましょう。
一人の開発者が手元で検索するだけなら、CLIで十分かもしれません。しかし、そのサービスを社内チャット、IDE、クラウドの業務エージェントから使わせたいなら、接続方法を共通化する価値が出てきます。
MCPなら、操作の取得から引数の確認までを共通の方式で扱えます。結果や追加入力の要求を扱う処理も、複数のサービスで再利用しやすいです。サービスの業務上の意味まで共通になるわけではありませんが、通信とツール契約を一から作り直す部分を減らせます。
従来は、そのために初期化やセッションなど、MCP特有の通信構造も扱う必要がありました。7月28日版はその負担を減らしました。さらに、遅延読み込みと結果の加工を実装すれば、CLIを選ぶ理由だったコンテキストの無駄にも対処できます。
次の表は、CLIが支持された理由に対し、MCPでどのように対応できるかを整理したものです。
| CLIを選ぶ理由だったこと | 現在のMCPで取れる方法 | そのうえで得られるMCPの利点 |
|---|---|---|
| 必要な使い方だけ読ませたい | ホストが必要なツール定義だけ提示する | 操作と引数を共通の形式で取得できる |
| 大量の結果をAIへ渡したくない | 検索引数やコード実行で加工する | 共通のツール契約を保ちながら組み合わせられる |
| 接続の状態管理を増やしたくない | 新仕様で要求ごとに通信条件を渡す | リモート統合を分散したHTTP基盤で扱いやすい |
| 手元にある道具をすぐ使いたい | ローカルではCLIを残し、リモート提供にMCPを使う | クラウドの各環境へ専用CLIを配る負担を減らせる |
最初の二行には、ホストやツールの実装が必要です。三行目は今回の仕様変更に直接対応します。最後の行は、CLIとMCPを併用できることを示しています。
したがって、すべてのコマンドをMCPへ置き換える必要はありません。ビルド、テスト、ローカルファイルの加工では、既存のCLIをそのまま使う構成が自然なことも多いです。既存CLIをMCPサーバーの内部から呼び、人間とシェルにはCLI、外部のAIアプリにはMCPを提供する構成も取れます。
SaaSやCRM、問い合わせ管理、社内データ基盤を複数のAIアプリへ提供するなら、接続先の対応状況も確認しながら、MCPを有力な候補として評価する価値があります。
9 まとめ
この記事の要点は、次の3つです。
- CLIが支持されたのには、実用的な理由がありました。 必要な説明だけを読み、結果をコードで加工し、既存の道具を再利用できることが、エージェントの仕事に合っていました。
- MCPでも、AIアプリ側の工夫で同じ課題に対処できます。 ツール定義の遅延読み込みやコード実行を実装すれば、モデルに渡す不要な情報を減らせます。これらは、プロトコルの仕様変更とは別の改善です。
- 2026年7月28日版は、通信と運用の負担を減らしました。 初期化とプロトコル上のセッションの撤去により、複数のサーバーへ処理を振り分けやすくなりました。クラウドエージェントから共通の接続を使う構成でも、この変更が役立ちます。
手元のビルドやファイル加工には既存のCLI、複数のAIアプリから使う業務サービスの接続にはリモートMCP、という使い分けが一つの目安です。利用するモデル・AIアプリ・サーバーがどこまで対応しているかも確認して選びます。
MCPの再評価を支えたのは、CLIが支持された理由への対応と、クラウドで運用しやすい通信設計です。これらを組み合わせることで、外部サービスへの接続を共通化するMCP本来の利点を、より小さな負担で使えるようになります。